 フリーランス求人を探す
エンジニアのための確率測度入門 ― 確率測度空間は「seed」で理解できる
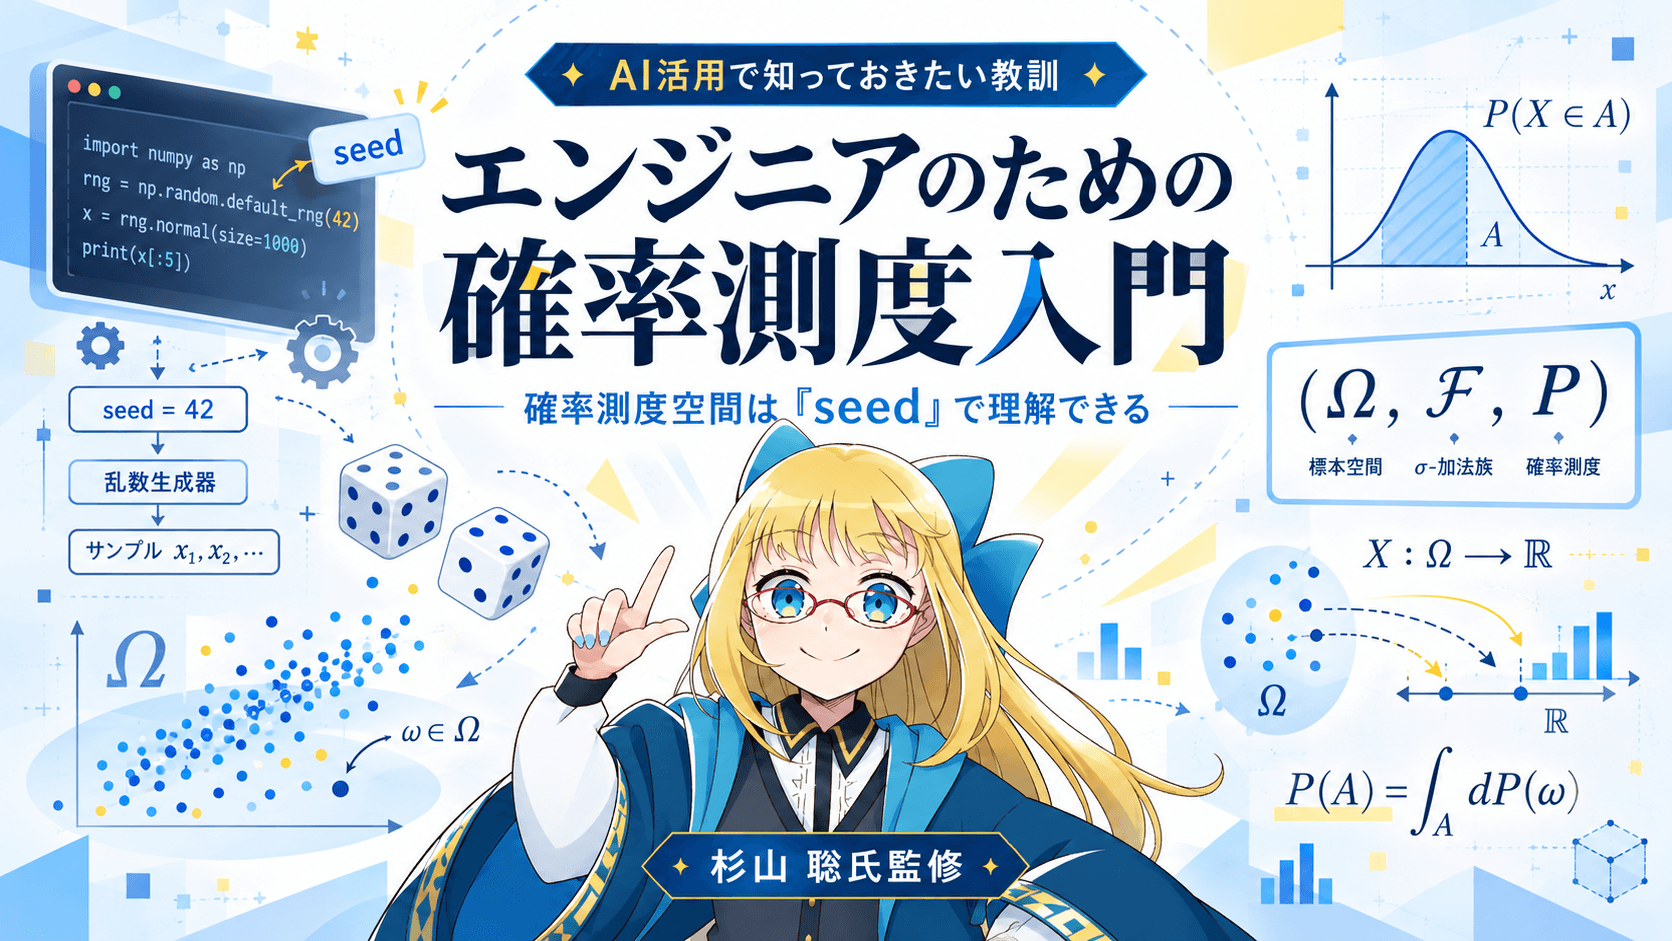
ハローワールド! データサイエンス VTuber のアイシア=ソリッドです。
この連載では、この大 AI 時代、AI 活用・開発において重要な考え方・知識をお届けしていくよ!
第5回のテーマは、エンジニアのための確率測度入門!
本記事の執筆者
アイシア=ソリッド(杉山 聡)AIcia Solid
データサイエンスVTuber
- 一般社団法人データサイエンティスト協会 スキル定義委員(データサイエンティストのスキル定義および検定プログラムの策定に従事)
- 大阪大学 D3センター 招へい研究員
- 慶應義塾大学 総合政策学部 島津明人研究室 上席所員(SFC上席所員)
- 株式会社アトラエ シニアデータサイエンティスト
学位:東京大学大学院数理科学研究科 博士課程修了。博士(数理科学)
受賞歴:第35回世界コンピュータ将棋選手権 優勝・独創賞特別賞(水匠チーム)
著書:『妥協しないデータ分析のための 微積分+線形代数入門』(2024年、ソシム)/『本質を捉えたデータ分析のための分析モデル入門』(2022年、ソシム)
TL;DR
- 「ランダムに値が変わるモノ」を実装しないといけない人が2種類いた。それが、IT エンジニアと数学者
- 確率測度空間や、その基礎の測度論は、数学者が作った実装
- とても飛躍した言い方をすると、確率測度空間とは random seed 全体の集合、確率測度とは各 random seed が選ばれる確率を決めるもの、確率変数は random seed から実数への関数、サンプリングとは random seed を1つ決めること
- 「数学的な細かい実装は分からないけど、μ(A) がそれっぽい値にちゃんとなってくれる実装があって、整備されている。あとはそれを使ってやりたい理論に集中すれば良い」という気持ちになれればOK!
- 普通の IT エンジニア(AI エンジニア含む)なら、この理解より深いことは必要ない。もし必要になったら、、、諦めて真面目に勉強してください
確率測度空間とは
確率測度空間は、現代の確率論で標準的に用いられる数学的枠組みです。
普通の人が扱うことはありませんが、数学者が確率を研究するときは、基本的にはこの確率測度空間が用いられます。
普通は使わないのですが、何やらかっこよさそうな AI・機械学習の解説や論文にたまに登場するんですよね。そして、「測度ってなに!? 確率測度空間ってなに!? 分からん!」という声をよく聞きます。
今日は、その確率測度空間を使うときの感覚をお伝えします。
この記事を読み終わるころには、「まぁなんかよく分からないけど、それほど怖いものじゃないんだな」という感覚になっていただければいいなと思います。
注
数学警察・IT 警察の方向けに補足します。本記事上では、厳密な表現より感覚や大枠のわかりやすさを優先します。そのため、数学的に・IT 的には問題のある表現が多分に含まれます。
数学・IT に覚えのある方は、ぜひその表現を発見・修正しながら読んでみてください。
それ以外の方はなにも気にせず、こういうもんだと思って読んでください。
確率の実装
確率的に値が変わる変数、ほしいですよね。
プログラミングの勉強をしていたら、ほとんど即座に欲しくなると思います。私の場合は、当時学んでいたプログラミングの教科書の具体例のなかに、おみくじプログラムがありました。そこでは、大吉から大凶までの結果が、指定された確率で登場するものを作りました。これで、ライブラリの利用と、if 文の勉強をした記憶があります。
現実の IT エンジニアの仕事でも、確率的に値が変わる変数は重宝されます。例えば、ガチャを実装したり、A/B テストにユーザーを振り分ける際など、ランダムななにかはよく用いられています。AI 開発をやっていても、train, val, test への split や、Diffusion Models の学習での noise 生成など、ランダムななにかはよく使っているでしょう。
しかし、ここで使われる乱数生成ライブラリがどのように実装されているか、あなたは勉強したことがあるでしょうか、、、?
話は変わって、IT エンジニアや AI エンジニア以外にも、「確率的に値が変わる変数」を求めた人々がいました。それが、数学者です。
袋の中に入った赤玉と白玉を連続して取り出してみたり、サイコロの出目の合計が3で割り切れるかどうか考えたり、そういう心躍る(?)問題を解くために、みなさんも確率変数をよく使っていたはずです。
「大きなサイコロの出目の値を表す確率変数をX、小さなサイコロの出目の値を表す確率変数をYとかく。X+Yが3で割り切れるのは X+Y = 3, 6, 9, 12 のときなので、、、」
と、こんな議論をやった記憶(トラウマ?)があるのではないでしょうか。
しかし、ここで使われる確率変数がどのように定義されているか、あなたは勉強したことがあるでしょうか、、、?
ここに踏み込む、つまり、測度論的な確率論について勉強するということは、ライブラリでの乱数の実装について理解することと同じだけの難しさがあります。
しかし、ライブラリと数学での確率の実装は、かなり似ている部分もあります。
この類似点を足がかりに、数学での確率の実装、確率測度空間を見ていきましょう!
IT と数学でのランダムの実装
厳密には異なりますが、プログラミングでの乱数は以下のように実装されていると思うことにしましょう。厳密には異なりますが、当たらずとも遠からずです。
- プログラムが乱数を計算する命令を出す
- まず、seed の値をランダムに決める
- seed の値が決まったら、その seed を用いて乱数の値を計算する
このとき、私たちにとっては以下が重要です:
- seed の選び方はよう分からん
- seed が決まれば、乱数の値は一意に決まる(もはやランダムでなく決定論的)
- seed から乱数の値を決める計算はよう分からん
- でも、結局、それっぽくランダムに動く
- サンプリングしたいときは、seed の値を1つ決めれば OK
「それっぽくランダムに動く」というのは、例えば、「Python で以下のように書くと、変数 x の値はちゃんと確率 1/6 で1になる」という意味です。
import random

x = random.randint(1, 6)杉山聡の深掘りメモ数学的な補足/読み飛ばしてもOK
今の考え方では、「x = 1 となる seed の選択確率が 1/6」と表現できます。
さて、確率測度空間とは、測度空間 Ω と確率測度 μ の組 (Ω, μ) のことで、確率変数 X は Ω から実数(等)への関数です。なにを言っているか意味不明だと思いますが、実はこの確率測度空間 (Ω, μ) と確率変数 X は、IT での確率の実装とかなり似たものです。上の例との対比で書くと、
- Ω: seed の値全体の集合
- μ: seed の選ばれ方を決めるモノ(詳細は後述)
- X: seed の値から実数への関数
です。このイメージを掴むことが今日の記事の目標です。
そのために、具体例で見てみましょう。
具体例
まず、IT エンジニア側と、数学側で、「サイコロを1回振った結果の出目」を実装してみましょう。
例えば、IT エンジニア側では、以下のような実装が考えられます。
まず、サイコロを振った瞬間の時刻を持ってきて、その秒数の小数点以下を見ます。それが1/6以下なら1、1/6〜2/6なら2……とすればよいでしょう。
こうすれば、ちゃんと「それっぽくランダムに動く」ことが期待できます。
つまり、確率 1/6 でその値は1になるなど、期待した性質を満たすでしょう。
数学側では、次のように作ります。
例えば、Ω は a から f までの6つの要素をもつ集合 Ω = {a, b, c, d, e, f} とします。
先ほど、μ は「seed の選ばれ方を決めるモノ」と表現しましたが、実際には、「事象に対して、その事象が起こる確率を決めるもの」です。
事象とは Ω の部分集合 A のことです。今回の場合、1〜6が等確率で出てほしいので、事象 A が起こる確率 μ(A) は、(A の要素数) x 1/6 としておきましょう。
サイコロの出目を表す確率変数は、X(a) = 1, X(b) = 2,…… と設定します。
こうすると、ちゃんと「それっぽくランダムに動」きます。
なぜならば、a〜f の値が選ばれるのはそれぞれ確率 1/6 なので、X の値が 1〜6 の値になるのもまた確率 1/6 だからです。
杉山聡の深掘りメモ数学的な補足/読み飛ばしてもOK
実際、X = 1 となるのは a〜f のうち a だけなので、X = 1 を表す事象(= Ω の部分集合)は {a} で、この確率 μ({a}) = ({a} の要素数) x 1/6 = 1 x 1/6 = 1/6 です。
こう作ってみると、実は、わかるポイントとよく分からんポイントは変わっていません。
- a〜f の選び方はよう分からん
- a〜f が決まれば、確率変数 X の値は一意に決まる(もはやランダムでなく決定論的)
- a〜f から確率変数 X の値を決める計算はよう分からん
- でも、結局、それっぽくランダムに動く
- サンプリングしたいときは、a〜f の値を1つ決めれば OK
限界と、発展
先ほど、2つの実装を紹介しました。これらはそれぞれ、1つのサイコロを振るだけなら完璧に仕事をこなしますが、2つ以上のサイコロを同時に振りたくなると問題が起こります。
IT エンジニア側の実装の問題は顕著で、2つ以上のサイコロを同時に振っても、全部のサイコロが必ず同じ出目を出してしまいます。
というわけで、実際には、何個同時にサイコロを振っても良いように、とんでもない量の工夫とアイデアと理論が注ぎ込まれて実装されています。
一般の IT エンジニアはその仕組みはよく分かっていませんが、とにかく、サイコロの出目をライブラリで計算したら、1〜6がそれぞれ確率 1/6 で出てくるようになっています。
数学の場合も、何個同時にサイコロを振っても良いように、とんでもない量の工夫とアイデアと理論が注ぎ込まれて実装されています。
具体的には、Ω がなんかよく分からない巨大な集合になり、μ がまた複雑な関数になり、確率変数 X もとても複雑でよく分からないものになります。
なのですが、例えばサイコロを3個振る場合、うまく確率変数 X_1, X_2, X_3 を選べば、X_1 = X_2 = X_3 = 1 となる確率がちゃんと 1/6 x 1/6 x 1/6 = 1/216 になるようにできています。
杉山聡の深掘りメモ数学的な補足/読み飛ばしてもOK
確率変数は Ω から実数への関数であり、事象は Ω の部分集合でした。
つまり、X_1, X_2, X_3 は Ω から実数への関数で、すべての値が1である事象は A = {ω ∈ Ω | X_1(ω) = X_2(ω) = X_3(ω) = 1} ⊂ Ω と書けます。この事象の確率が1/216ということは、μ(A) = 1/216 であるということです。
より正確に言うと、こういう X_1, X_2, X_3 が存在するよう、事前になんかすごくいい感じの Ω と μ を数学者が作ってくれているよ、ということです。
サイコロを何個振っても耐えられる Ω と μ を作るのは至難の業ですし、正規分布などの連続分布を受け入れられる Ω と μ を作るのはもっと大変な作業です。
本当にこれに踏み込むと大変なことになるので、よほどのことがない限りはやめておきましょう。
数学者がちゃんと問題なく動くものを用意してくれているので、私たちは巨人の肩に乗ることにしましょう!
今最初に理解しておくべきは、以下の対応です。
| プログラミング | 数学 | |
|---|---|---|
| 使うもの | 乱数ライブラリ | 確率測度空間 (Ω, μ) |
| seed | ω ∈ Ω | |
| seed 全体の集合 | Ω | |
| 確率変数 | seed から float(等)への関数 | Ω から実数(等)への関数 |
| サンプリング | seed を1つ決める | ω を1つ決める |
| P(X = 1) | X = 1 となる seed の選択確率 | μ({ω ∈ Ω | X(ω) = 1})(X(ω) = 1 となる事象の確率) |
杉山聡の深掘りメモ数学的な補足/読み飛ばしてもOK
ちなみに、IT 側で積み上げられた工夫を詳細に見つつ、確率的な振る舞いに陰に陽に影響する変数をすべて集めた巨大なデータを “seed” と呼ぶことにすれば、最初のナイーブな実装の表現は正当化されます。また、その巨大さと複雑さを思い浮かべると、ちょうど、確率測度空間に必要な努力の量も想像がつくかと思います。すごく雑に言えば、だいたい同じ量の努力があります。
もっと深く理解したい人は
読み飛ばしOK|より深い理解を目指したい人向け
ここは、より深い理解を目指したい人のみ読んでください。興味がない人は、次のセクションまで飛んでください。
今までの確率の考え方と、確率測度空間の考え方の間には、大きな転換があります。たとえば、今までの考え方で、標準正規分布に従う確率変数 X を考えるとしましょう。このとき、普通は、確率密度関数 p(x) を用意して、X の値が a から b にある確率は
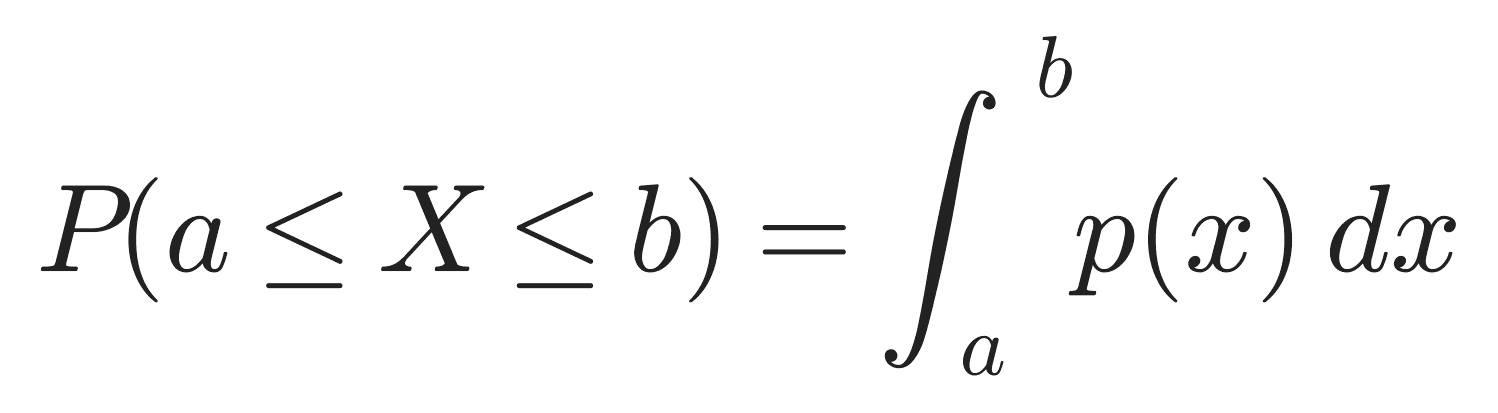
で計算するでしょう。最初は面食らうと思いますが、慣れればなんてことない計算です。
一方、確率測度空間を用いて確率変数 X を考える場合、まずよく分からない巨大な測度空間 (Ω, μ) を用意し、X は Ω から実数への関数としてなんとか作り、a から b の値を取る確率を計算するためには、よく分かんない部分集合 A = {ω ∈ Ω | a ≤ X(ω) ≤ b} ⊂ Ω を作り、これとよく分かんない μ をあわせて、
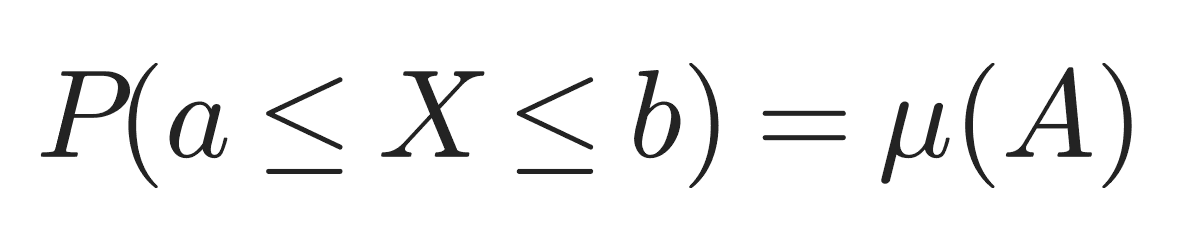
と計算されます。
使ってる物体は全部なんかよく分からないんだけど、計算結果だけはうまく整合する謎のシステム (Ω, μ) と X を用いて、それで計算する。これが、確率測度空間でやられていることです。
(よく考えたら、ライブラリを使うときでも同じような、、、)
いつ測度論を学ぶか
確率測度空間などを厳密に扱う分野は、測度論と呼ばれます。そのなかでも、積分を扱うための中心的な道具のひとつがルベーグ積分(Lebesgue 積分)です。これをちゃんと理解する勉強は本当に大変です!
これが必要になるのは、「極限」を本質的に使うときや、ブラウン運動や確率微分方程式など無限次元を扱う必要があるときなどです。
例えば、概収束、確率収束、分布収束、、、なんかが出てきて、これらの違いや性質を根源から理解する必要に迫られたときや、確率微分方程式の深淵に踏み込むときなどです。
それ以外は、だいたい、測度とかナントカ言われても、ざっくり確率密度関数を思い浮かべて考えておいて、それで問題になることはあまりありません。
測度論を学ぶことは、Computer Science の基礎1分野を学ぶことと同じようなものです。本当に必要になることはほとんどないが、まぁ知っていると嬉しかったり、たまに直感が鋭くなったりする。そのために勉強するには大変すぎる。そんなもんです。
それでもなお、「私は学びたい!」と思うのであれば、こういう記事を入口にしつつ、しっかりした教科書などで入門してみてください。
まとめ
本記事の要約は以下のとおりです。
- 「ランダムに値が変わるモノ」を実装しないといけない人が2種類いた。それが、IT エンジニアと数学者
- 確率測度空間や、その基礎の測度論は、数学者が作った実装
- とても飛躍した言い方をすると、確率測度空間とは random seed 全体の集合、確率測度とは各 random seed が選ばれる確率を決めるもの、確率変数は random seed から実数への関数、サンプリングとは random seed を1つ決めること
- 「数学的な細かい実装は分からないけど、μ(A) がそれっぽい値にちゃんとなってくれる実装があって、整備されている。あとはそれを使ってやりたい理論に集中すれば良い」という気持ちになれればOK!
- 普通の IT エンジニア(AI エンジニア含む)なら、この理解より深いことは必要ない。もし必要になったら、、、諦めて真面目に勉強してください
Ω は seed の集合。サンプリングは seed の決定。seed が決まれば確率変数の値も決定論的に決まるので、確率変数は要は seed から値への(副作用のない)関数。確率は、部分集合と μ を使って計算するっていう設定になってる。
あとはなんか測度論にはそれっぽいかっこいい記号がたくさんあるけど、それらは所詮 syntax sugar で、定義見て慣れれば OK。
そんなもんだけ押さえておけば、それ以上の深入りはしなくて良いんじゃないでしょうか!
(深入りしたい人は、ぜひ、沼へようこそ、、、!)
以上。データサイエンス VTuber の、アイシア=ソリッドでした!
次回もお楽しみに!
AI drops 編集部より:
「巨人の肩」に乗って、理論と実装をつなぐ仕事をしませんか?
確率測度空間のような数学の土台を、細部まで踏み込まずとも「正しく使いこなせる」こと。論文や理論の前提を押さえ、実装へと落とし込めることは、AI・機械学習に携わるエンジニアにとって大きな強みです。
BIGDATA NAVIでは、理論への理解をモデル開発や分析の現場で活かせる、月額100万円を超えるハイエンドなAI・データサイエンス案件を多数保有しています。あなたのスキルを正当に評価し、力を発揮できる環境をご紹介できます。まずは一度、当社の無料サポートをご活用ください。

AIを仕事にするためのキャリアノウハウ、機械学習・AIに関するTopics、フリーランス向けお役立ち情報を投稿します。