 フリーランス求人を探す
LLM(大規模言語モデル)とは?生成AIとの違い・仕組み・活用事例をわかりやすく解説
ChatGPTをはじめとするチャットボットの仕組みに欠かせない大規模言語モデル(LLM)。
LLMは、膨大なテキストデータから言葉のパターンや文脈を学習し、質問への回答や文章作成、要約、翻訳などを行えるAIモデルです。
一方で、「LLMと生成AIは何が違うのか」「ChatGPTそのものがLLMなのか」「どのような仕組みで自然な文章を作っているのか」と疑問に感じる方も多いでしょう。
この記事では、LLMの仕組みや具体例、活用例について解説いたします。
生成AIやChatGPTとの違い、ビジネスへ導入する際の注意点まで紹介するため、LLMについて基礎から理解したい方はぜひ参考にしてください。
- LLM(大規模言語モデル)の意味と特徴
- LLMと生成AI・ChatGPT・NLPとの違い
- LLMが文章を理解・生成する基本的な仕組み
- GPT・Gemini・Claude・Llamaなど代表的なLLM
- LLMのビジネス活用事例と導入時の注意点

目次
LLMとは?基本概念と特徴
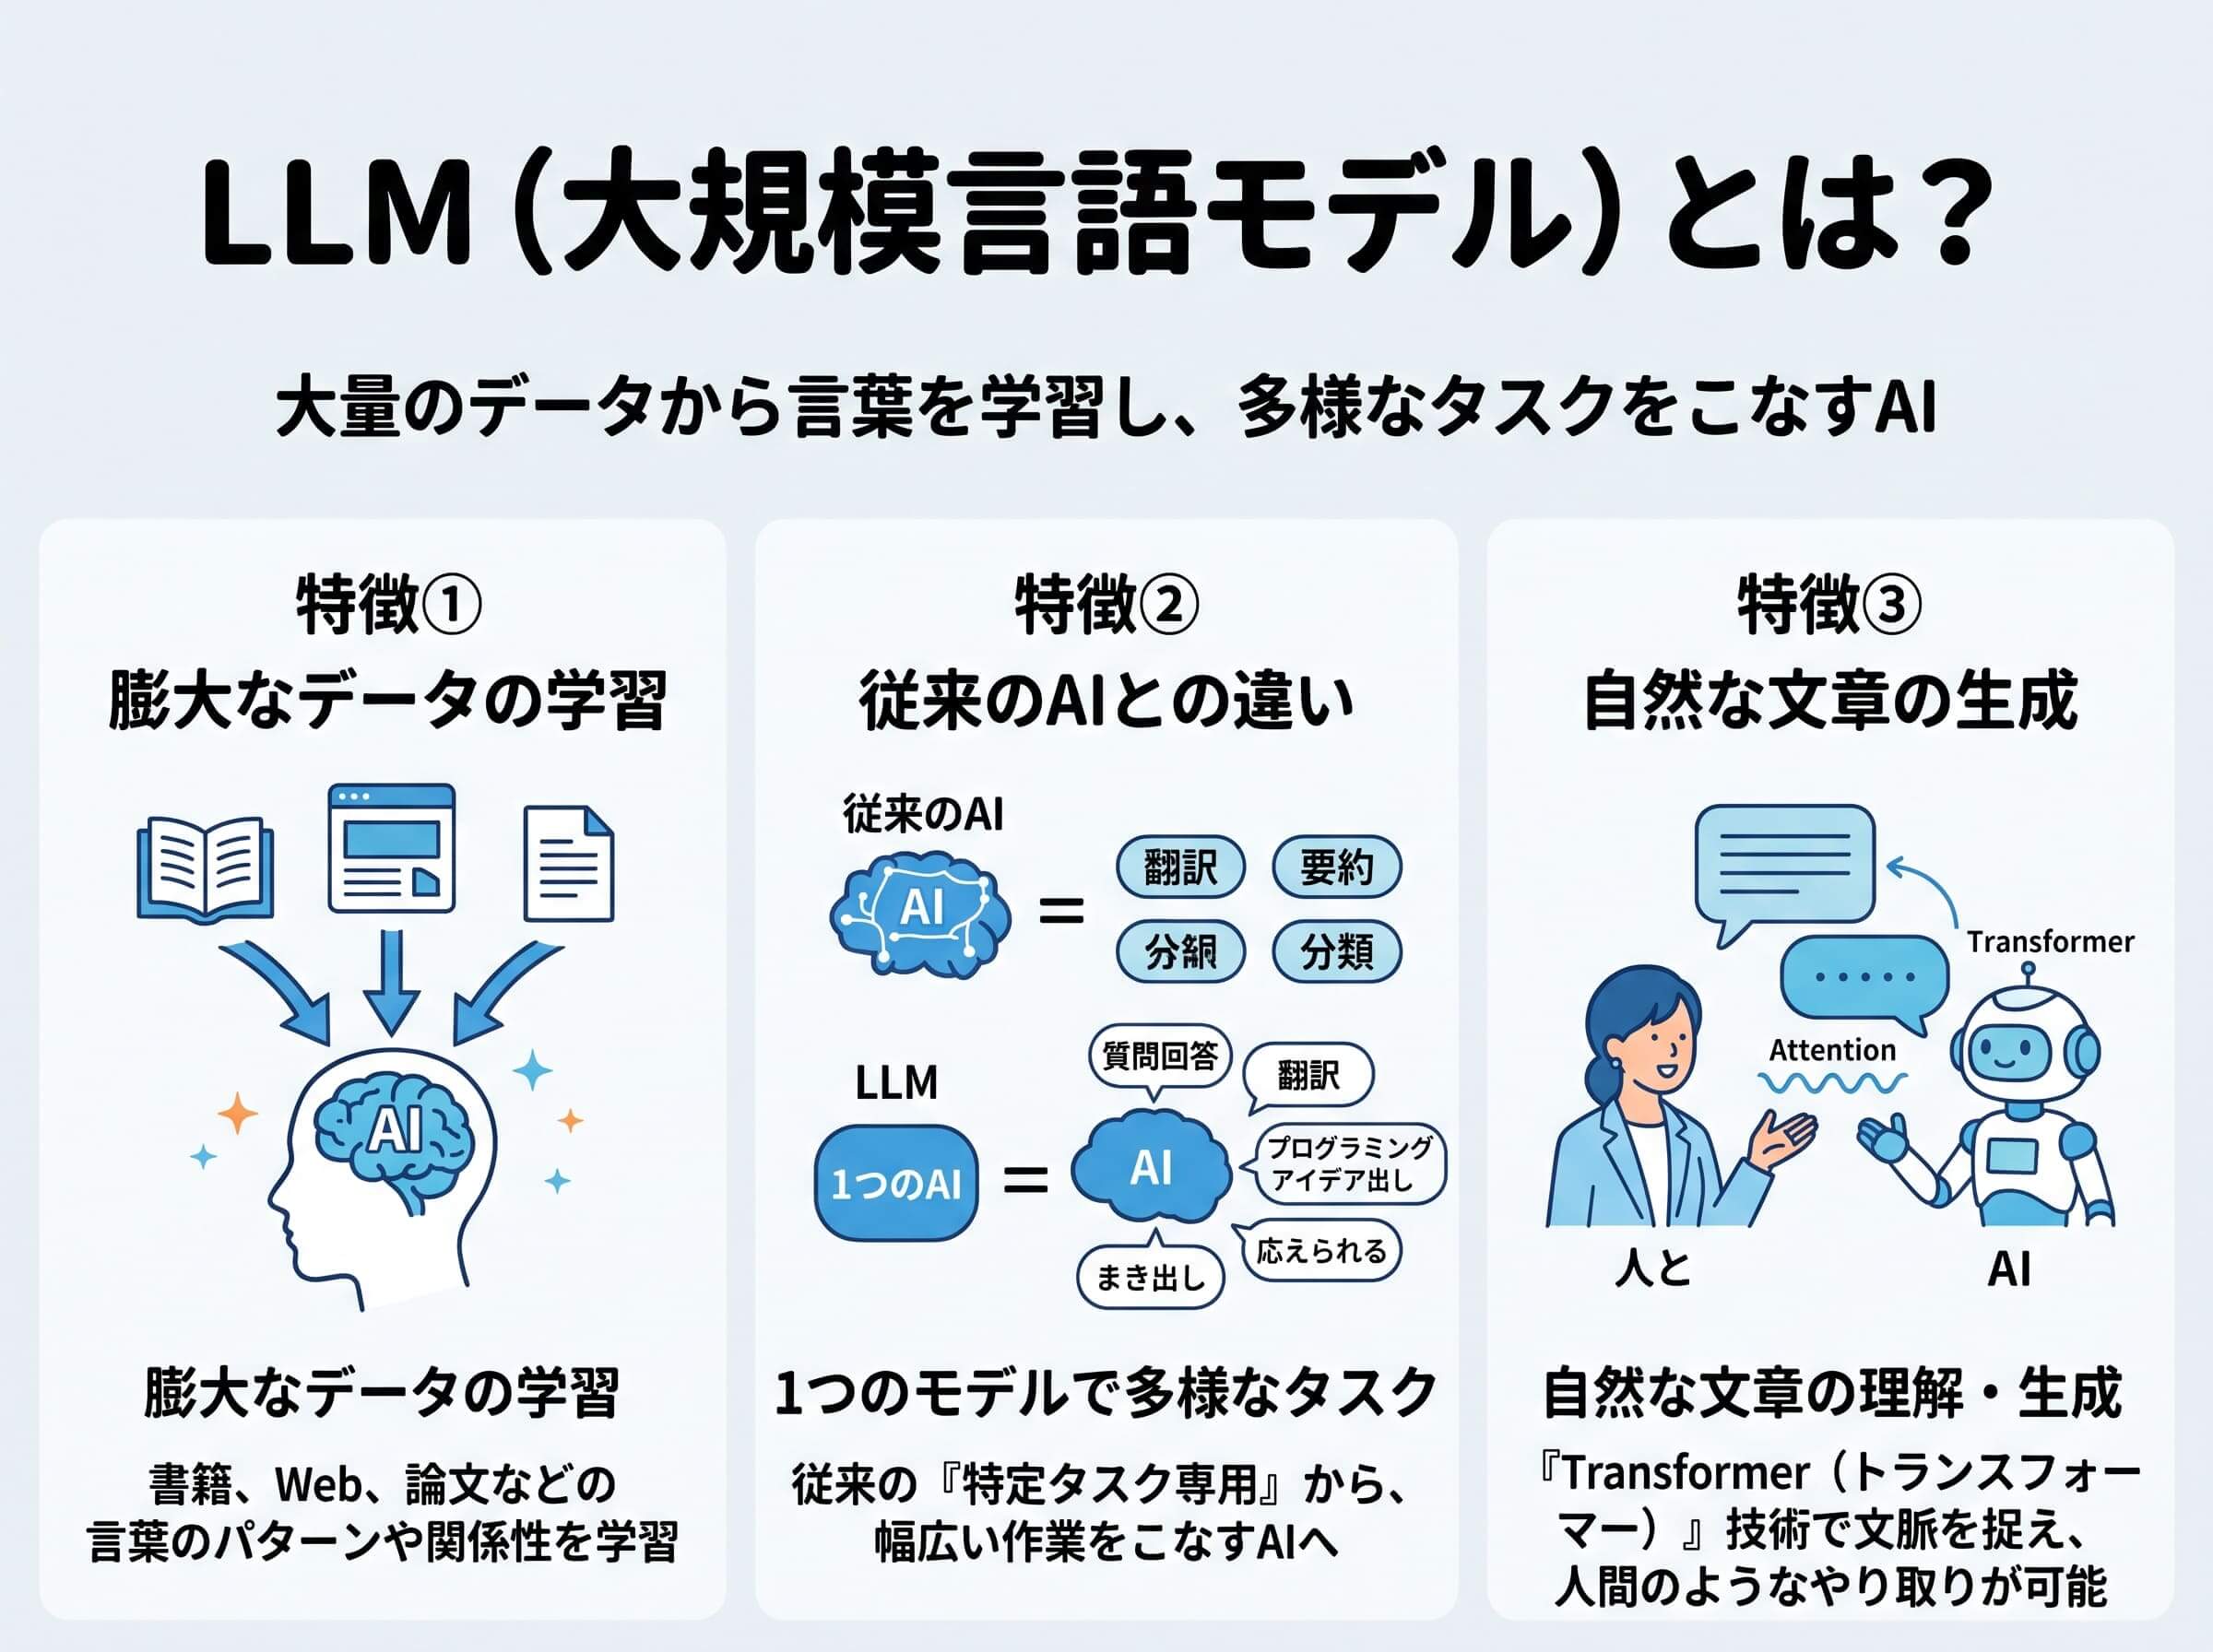
LLMとは「Large Language Model」の略で、日本語では「大規模言語モデル」と呼ばれます。
大量のテキストデータと大規模なニューラルネットワークを利用して学習することで、文章の意味や文脈を捉え、自然な文章を生成できる点が特徴です。
ここでは、LLMの基本的な特徴について以下の3つの視点から解説します。
大量のテキストデータを学習したAIモデル
大規模言語モデル(LLM)とは、AIが膨大な量のテキストデータを用いて学習した自然言語処理モデルのことです。
「Large Language Models」の略語であるLLMが通称として用いられることが多いです。
書籍やWebページ、論文などさまざまな文章に含まれる言葉の使われ方や関係性を学習することで、入力された文章に対して適切と考えられる回答を生成するのが特徴です。
なお、一般的な検索エンジンとは仕組みが異なり、LLMは学習データから言葉同士の関係や出現パターンなどを学び、それらをモデル内部のパラメータとして保持しています。
モデルや学習方法によって違いはあるものの、膨大なデータと多数のパラメータを利用して汎用的な言語能力を獲得しているのがLLMの大きな特徴といえるでしょう。
従来のAIとの決定的な違い
従来のAIもプログラムとして実行・処理されますが、特定の目的やタスクに合わせて設計されるのが一般的でした。
一方、LLMではAIが自然言語を理解・生成し、一つのモデルで幅広いタスクに対応できるという特徴があります。
たとえば従来のシステムでは、「問い合わせ内容を分類するAI」「文章を翻訳するAI」「文章を要約するAI」など、目的ごとに異なる仕組みを構築していました。
しかしLLMでは、ユーザーが自然言語で指示を与えるだけで、質問への回答、文章作成、翻訳、要約、情報整理、アイデア出し、プログラミングなど複数の作業に対応できます。
つまり、特定の処理だけを行うAIから、人間が普段使っている言葉をインターフェースとして幅広い作業を依頼できるAIへ発展しているのです。
ただし、LLMは人間と同じように言葉の意味を理解しているわけではありません。あくまで学習したデータや入力された文脈をもとに、統計的・計算的に適切な出力を生成していることを理解しておきましょう。
自然な文章を理解・生成できる理由
自然言語とは、日本語や英語など普段使っている日常言語のことですが、その表現には多くの曖昧性が含まれています。
たとえば同じ単語でも前後の文章によって意味が変わったり、主語が省略されたりすることがあります。
こうした表現を単純なルールだけで処理することは容易ではありません。
深層学習によって大量のテキストデータを学習し、一般的なプログラミング言語では理解できないこれらの曖昧性を含めて処理できるのがLLMです。
人間が作成したものと区別がつかないほど自然な文章を生成したり、複雑な質問に答えたり、文章を複数の言語に翻訳したりといった、数多くのタスクに対応することを可能にしています。
その中心となっている技術の一つが「Transformer(トランスフォーマー)」です。
Transformerでは「Attention(アテンション)」と呼ばれる仕組みによって、文章内のどの言葉同士の関係が重要なのかを捉えながら処理します。
そのため、単語を一つずつ独立して扱うのではなく、前後の文章や会話の流れを踏まえた出力を生成できるようになっています。
LLMと生成AI・関連技術の違い
LLMは自然言語処理の分野で大きな注目を集めていますが、実際には似たような言葉や関連する技術が多く存在します。
そのため、「LLMと生成AIは同じ意味なのか」「従来の機械学習とはどう違うのか」といった疑問を持つ方もいらっしゃると思います。
また、RAGやLMMといった新しいアプローチも登場していることから、用語の整理がますます重要になっています。
まず、それぞれの概要を簡単に整理すると以下のようになります。
| モデル | 概要 |
|---|---|
| LLM | 大量の言語データを学習したモデル |
| 生成AI | テキスト・画像・音声などを生成するAI |
| ChatGPTなど | AIモデルを手軽に利用できるサービス |
| 機械学習 | データから規則やパターンを学習する技術 |
| NLP | コンピュータで自然言語を扱う技術分野 |
生成AIとの違い
LLMはテキストデータをベースとして、文脈を学習し自然な文章を生成したり理解したりする能力を持つモデルです。
生成AIはその用途に焦点を当てた言い方であり、画像生成や音声生成、あるいはテキスト生成を行うモデル全般を指します。
生成AIはLLMを含む概念ですが、LLMは主にテキストの生成と理解に特化しています。
生成AIでは、たとえば画像や音響などテキスト以外のメディアも生成対象になるため、その設計や訓練データ、評価方法が異なることがあります。
ただし、近年はLLM自体も画像や音声などを扱えるようになり、LLMと大規模マルチモーダルモデル(LMM)の境界は徐々に曖昧になっています。
ChatGPTなどの対話型AIサービスとの違い
LLMは、文章の理解や生成を担うAIモデルです。
一方、ChatGPTなどはLLMを利用してユーザーが実際にAIとやり取りできるようにしたサービス・アプリケーションにあたります。
自動車に例えるなら、LLMがエンジンであり、ChatGPTなどの対話型AIサービスがエンジンや操作装置、安全機能などを組み合わせた自動車全体に近い関係です。
実際の対話型AIサービスでは、LLMによる文章生成だけでなく、Web検索、ファイルの読み込み、画像認識、外部ツールとの連携など、複数の機能が組み合わされるのが特徴です。
機械学習・自然言語処理(NLP)との違い
「機械学習」は、データからパターンを学び予測や分類を行う広い分野を指します。
LLMはこの機械学習の一部であり、特に自然言語を扱うニューラルネットワークを用いて、大規模なテキストを訓練データとして言語的・構文的な知見を取得します。
一方、伝統的な機械学習モデル(例:決定木、SVM、線形回帰など)は比較的少ないデータ量で特定タスクを解くことが多く、特徴量設計が必要なことが多いです。
LLMでは特徴量設計よりもモデル自身が文脈や関係性を内部で捉える能力を持つため、タスクを問わず多様な自然言語処理に適用できる柔軟性があります。
NLP(Natural Language Processing:自然言語処理)は、人間の言語をコンピュータに理解・生成・処理させる一連の技術や理論を指す総称です。
形態素解析・品詞タグ付け・依存構造解析・翻訳・要約など多くのタスクが含まれます。
LLMはそのNLPの中で、より高度でジェネレーティブなタスク、また文脈を長範囲にわたって理解するタスクに強みがあります。
つまり、NLPが包含する技術の多くを使いつつ、LLMは「テキスト生成」「コンテキスト理解」「対話型応答」などをより自然に・高精度にできるアプローチです。
NLPがタスク中心・アルゴリズム中心であるのに対し、LLMは大規模データとモデルの表現力を活かし、「学習済み言語モデル」を核とした応答や生成を重視します。
LLMの基本的な仕組み
LLMが自然に文章を生成できる背景には、複雑かつ高度な仕組みがあります。
大まかには、文章をコンピュータが扱えるデータへ変換し、大量の文章から言語のパターンを学び、入力された文章に続く適切な言葉を予測するという処理が行われています。
この流れを理解することで、なぜLLMがここまで自然で高精度な応答を可能にしているのかが分かります。
文章を単語に分けて数値化する処理
LLMが文章を処理する際、最初に行われるのがトークン化と呼ばれる処理です。
コンピュータは、日本語や英語の文章を人間と同じ形のまま理解しているわけではありません。
そのため、入力された文章をトークンと呼ばれる処理単位に分割します。
その後、各トークンをモデルが計算できる数値表現へ変換します。
これが埋め込み(Embedding)などと呼ばれる処理です。
数値化されたトークン同士の位置や関係性をニューラルネットワークで処理することで、言葉同士の意味的な関係も捉えられるようになるのです。
前後の文脈から次の言葉を予測する技術
LLMの文章生成では、前後の文脈から次の言葉を予測する技術、つまり次に続くトークンを予測するという技術が用いられています。
たとえば「日本の首都は」という文章が与えられた場合、学習したパターンや文脈をもとに、次に「東京」という言葉が続く確率が高いと判断します。
「東京」が生成された後は、そこまでの文章全体を踏まえてさらに次のトークンを予測するといった処理を繰り返して、一つの文章や長い回答が形成されていきます。
人間の好む回答に合わせる追加学習
近年では、人間の好みを学習する方法にもさまざまな手法が用いられており、モデルによって具体的な学習工程は異なります。
例えば、質問と望ましい回答の例を使って学習させる「教師ありファインチューニング」や、人間が複数の回答を評価し、その評価をもとにモデルを最適化する「RLHF(Reinforcement Learning from Human Feedback:人間のフィードバックによる強化学習)」などが代表的です。
こうした追加学習によって、単に文章を続けるだけではなく、質問に答える・指示された形式で出力する・危険な内容にも適切に対応するといった、対話型AIとしての能力が高められています。
LLMの代表的なモデル一覧
LLMは多くの企業や研究機関によって開発されており、用途や性能、利用方法にも違いがあります。
ここでは、代表的な4つのモデルについて解説します。
GPTシリーズ(OpenAI)
GPTは、OpenAIが開発しているAIモデルのシリーズです。
文章生成、質問応答、要約、翻訳、プログラミングなど幅広い用途で利用されており、OpenAIの対話型AIサービスであるChatGPTにもGPTシリーズの技術が活用されています。
2026年10月時点ではGPT-6 Astra、GPT-6.1 Sol、GPT-6 LunaなどがOpenAIのモデルとして提供されており、複雑な推論を重視する用途から、高速・低コストな大量処理まで目的に応じて使い分けられるようになっています。
また、近年のGPTシリーズはテキストだけを扱う従来型のLLMから発展し、画像入力やツール利用などにも対応しています。
そのため、単純な文章生成モデルというよりも、さまざまな情報やツールを組み合わせてタスクを実行するまで役割が広がっています。
Gemini(Google)
Geminiは、Googleが開発しているAIモデルシリーズです。
テキストだけでなく、画像や音声など複数の種類の情報を扱えるマルチモーダルAIとして設計されていることが特徴でGemini 4 ArgonやGemini 3.8 Flashなど複数のモデルが提供されており、高度な推論から高速な処理、音声を扱う用途まで幅広く活用できます。
Googleの各種サービスやGoogle Cloudなどとの連携も進められており、個人向けの生成AIだけでなく、企業が業務システムへAIを組み込む際の基盤としても活用できるのが特徴です。
Claude(Anthropic)
Claudeは、AI企業のAnthropicが開発しているAIモデル・対話型AIのシリーズです。
文章の作成や要約、分析、プログラミングなど幅広い作業に利用でき、長い文書や大量の情報を扱う用途にも活用されています。
Claude Opus 5.5、Claude Sonnet 5.5、Claude Haiku 5.5などが公開されており、コーディングや知識労働、エージェント型のタスクなどへの対応も強化されているのが特徴で、章の作成や要約、分析、プログラミングなど幅広い作業に活用されています。
また、安全性やモデルの評価方法に関する情報も公開されている点がAnthropicの特徴です。
Llama(Meta)
Llamaは、FacebookやInstagramなどを運営するMetaが開発しているAIモデルシリーズです。
GPTやClaudeなどの商用サービスとして提供されるモデルとは異なり、モデルウェイトを入手して自社環境やクラウド環境で利用できるため、独自のAIサービスを開発したい企業や研究者によるモデルの検証、カスタマイズなどにも広く利用されています。
現在のLlama 4には、長いコンテキストを扱えるScoutや、画像とテキストの理解などに対応するMaverickなどがあり、テキストだけでなく画像も扱えるネイティブマルチモーダルモデルとして提供されています。
LLMのビジネス活用事例
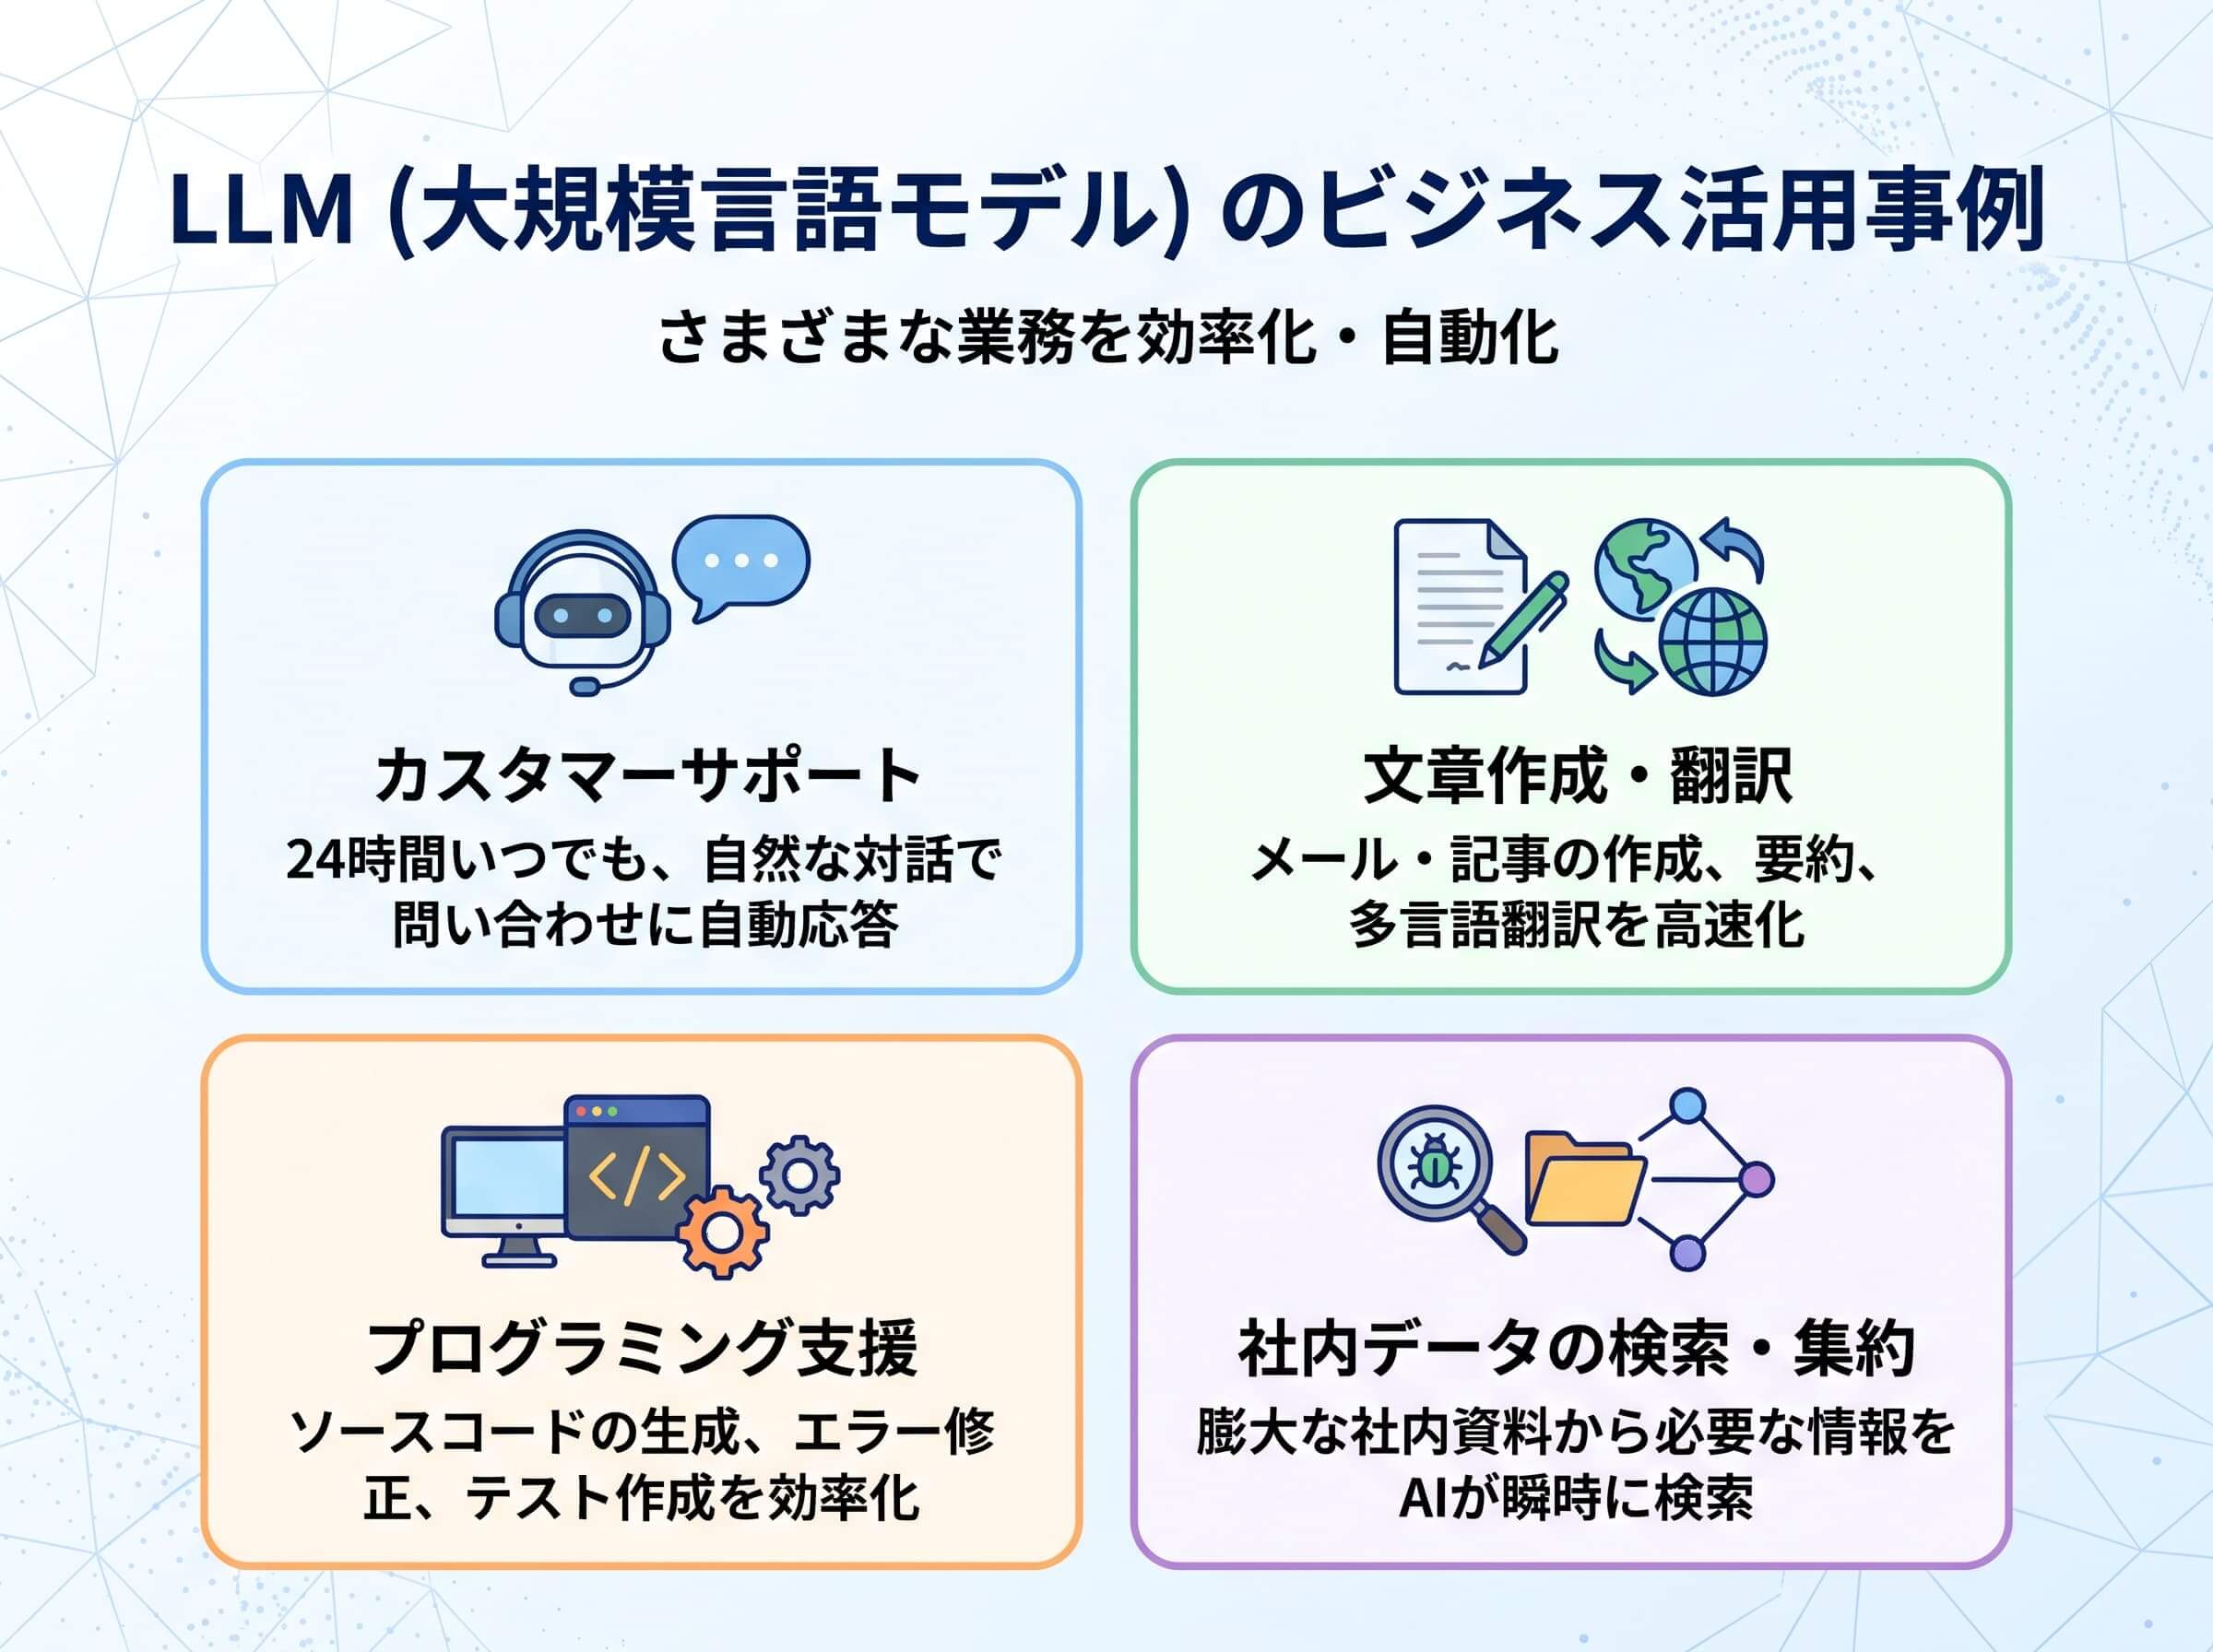
LLMは単なるチャットボットとしてだけでなく、問い合わせ対応、資料作成、情報検索、プログラミングなど企業のさまざまな業務に活用できます。
ここでは、LLMのビジネス活用事例を紹介します。
問い合わせ対応やカスタマーサポートの自動化
LLMの代表的な活用方法の一つが、問い合わせ対応やカスタマーサポートです。
従来のチャットボットでは、事前に登録した質問と回答を照合したり、選択肢を表示したりする方式が多く、想定していない表現の質問には回答しにくいという課題がありました。
LLMを利用すれば、ユーザーが日常的な言葉で入力した質問の意図を捉え、それに応じた回答を生成できます。
たとえば、商品の使い方、契約内容、配送状況、社内手続きなど、問い合わせ件数の多い内容をAIに一次対応させることが可能です。
また、自社のFAQやマニュアルとRAGを組み合わせることで、企業独自の情報を参照した回答もできるため、担当者の負担を軽減できます。
文章作成や要約・多言語翻訳の効率化
LLMは、メールの下書き、議事録の要約、企画書のたたき台、商品説明文、社内マニュアル、求人原稿など、日常業務で発生する文章作成の効率化にも活用できます。
また、海外企業とのメールや資料の翻訳、外国語による問い合わせへの回答案作成などをAIに任せれば、言語の壁を越えたコミュニケーションも可能になります。
プログラミングやソースコード生成の支援
LLMは自然言語だけでなく、PythonやJavaScriptなどのプログラミング言語も学習しているため、「CSVファイルを読み込んで集計するPythonコードを作成してほしい」のように自然言語で指示するだけでソースコードを生成させることが可能です。
コードの新規作成だけでなく、既存コードの説明、エラーの原因調査、テストコードの作成、リファクタリング、仕様書の作成などにも活用可能で、プログラミング経験の少ない担当者が簡単な処理を自動化する際の補助として利用するケースもあります。
社内データの検索と情報集約
企業には、マニュアル、社内規定、議事録、営業資料、技術文書など大量の情報が蓄積されているため、必要な情報がどのファイルに書かれているのかわからず、社員が資料を探すだけで時間を費やすこともあるでしょう。
そこで活用できるのが、LLMとRAG(Retrieval-Augmented Generation:検索拡張生成)を組み合わせた社内検索です。
RAGでは、ユーザーから質問を受けると社内文書などから関連する情報を検索し、その情報をLLMへ渡して回答を生成することで、自社データに基づいた回答が得られます。
たとえば、「出張費の申請方法を教えて」「この製品の過去のトラブル事例をまとめて」といった自然言語で検索可能な社内AIを構築することも可能です。
LLMの課題と導入時の注意点
LLMは多くの業務を効率化できますが、以下のような注意点や課題も存在します。
ハルシネーションへの対策
LLMは学習したパターンや与えられた文脈から次のトークンを予測して文章を生成しているため、事実ではない内容をもっともらしく回答してしまう「ハルシネーション」が発生することがあります。
そのため、LLMの回答をそのまま事実として扱うのではなく、重要な内容については一次情報や信頼できる資料で確認する必要があります。
対策としては、企業でLLMを利用する場合には、RAGによって参照する情報源を限定したり、回答と一緒に参照元を表示したりする方法が有効です。
また、医療、法律、金融など誤った情報が重大な結果につながる分野では、AIだけで最終判断を行わず、専門家や担当者による確認を組み込むことが大切です。
情報漏洩やセキュリティリスクへの対策
企業でLLMを利用する際は、個人情報や機密情報の漏洩に注意が必要です。
顧客情報や未公開の資料などを外部の生成AIサービスへ入力すると、情報管理上の問題につながる可能性があります。
また、LLMを社内システムや外部ツールと連携させる場合は、悪意のある指示によって想定外の動作をさせる「プロンプトインジェクション」や、不適切なアクセス権限による情報流出にも注意が必要です。
対策として、入力できる情報のルール化やアクセス権限の制限、ログ管理などを行い、LLM単体ではなくシステム全体でセキュリティを確保することが重要です。
開発・運用のコスト負担への対策
LLMの利用には、開発費だけでなく継続的な運用コストも発生します。
APIを利用するサービスでは、一般的に入力・出力するトークン数などに応じて費用が発生するため、利用人数や処理する文書量が増えるとかかるコストも大きくなります。
また、自社でLLMを動かす場合はモデルを運用するエンジニアが必要ですし、RAGを利用する場合は文書のデータベース化、検索基盤の構築、情報更新、回答品質の評価などにもコストがかかります。
費用削減のためには、複雑な分析だけを高性能モデルに任せ、文章分類や定型処理には小型で低コストなモデルを使用するといったモデルの使い分けが有効です。
LLMが注目される理由と今後の展望
ここでは、LLMが社会やビジネスに与える影響と今後の展望を紹介します。
社会やビジネスに与える影響の大きさ
LLMが注目される理由の一つは、文章作成や要約、質問への回答、情報の検索・抽出、多言語翻訳など、これまで人間が手作業で行っていた業務を圧倒的に効率化できることです。
また、マーケティングやカスタマーサポート、営業など文章や情報を扱う業務はもちろん、教育や金融、医療などさまざまな分野で活用できることから、社会やビジネスに与える影響も大きいと考えられています。
たとえば、顧客対応の自動化や資料作成、学習支援、情報分析など、業界ごとの課題に応じた使い方ができます。
こうした汎用性の高さから、LLMは業務効率化だけでなく、新たなサービスやビジネスモデルの創出にもつながる技術として注目されています。
画像や音声も処理できるマルチモーダル化
LLMをはじめとする生成AIは、テキストだけでなく画像や音声、映像なども扱えるマルチモーダル化が進んでいます。
複数の種類の情報を扱えるモデルはLMM(Large Multimodal Model)とも呼ばれ、たとえば画像の内容を読み取って説明文を生成したり、映像の内容を要約したりすることが可能です。
マルチモーダル化によって、資料内の文章とグラフをまとめて分析する、音声による問い合わせ内容を理解するといったことが可能になるため、今後は文章を入力して文章を返すAIから、さまざまな形式の情報をまとめて理解・処理できるAIへ発展していくと考えられます。
自律して作業を行うAIエージェントへの進化
LLMの活用は、質問に答えるだけのチャット型AIから、目的に合わせて複数の作業を進める「AIエージェント」へと広がっています。
AIエージェントは、LLMを活用して必要な情報を調べたり、外部ツールを使ったりしながら、目的を達成するために必要な手順を順番に進めていく仕組みです。
そのため、単に回答を返すだけでなく、情報収集から整理、資料作成までを一連の流れとして任せられるようになります。
今後は、顧客対応や情報収集、資料作成など、これまで人が複数の工程に分けて行っていた業務をAIがまとめて支援する場面も増えていくと考えられます。
まとめ
大規模言語モデル(LLM)とは、膨大な量のテキストデータをもとに学習し、文章作成や翻訳、質疑応答などの自然言語処理を行うAIモデルです。
生成AIの中でも、特に言語を扱うための重要な技術として活用されています。
ビジネスでは、問い合わせ対応や文章作成、プログラミング、社内情報の検索など、さまざまな用途で業務効率化が期待できます。
一方、ハルシネーションや情報漏洩、運用コストといった課題もあるため、特性を理解したうえで利用することが重要です。
今後はマルチモーダル化やAIエージェントへの発展によって、LLMの活用範囲はさらに広がると考えられます。
自社の目的や課題に合わせて適切に活用することが、業務効率化や新たなビジネス価値の創出につながるでしょう。
AIを仕事にするためのキャリアノウハウ、機械学習・AIに関するTopics、フリーランス向けお役立ち情報を投稿します。